不靠猜:如何用 TRM 推导出 PCIe 模块的问题
18 分钟阅读
这是我在 RK3588 上做 PCIe 3.0 bring-up 时的一段真实调试经过。调试的结果是硬件出问题,对我来说,这比把模块调通更有意义,因此出错时自己被倒逼反复的死抠每一个路径上遇到的技术细节,直到完成,比起轻松的调通,其实我对rk3588的pcie模块理解得更深。重要的是:整个过程里,我每一步都拿得出证据,说清楚"卡在哪、为什么卡、下一条路该往哪走"。
这篇文章的前 70% 是第一人称的时间线复盘(我怎么一步步逼近根因、走过哪些弯路),后 30% 是我从这次经历里提炼出的反思。文末链到我沉淀的 SoC 板级 Bring-up 工程手册——这篇 PCIe 案例,就是那套方法在最深一层的实战。
0. 引子:CPU7 上的沉默
最初的sdk里,pcie30phy的mode就是NANBNB,即不聚合,port0和port1的2Lane不单独分开,乃是合并为一个独立的2Lanes通道使用。且pcie3x4是打开的。
但是,一旦我修改了dts里的配置,板端起 PCIe 驱动之后,CPU7 的 rk-pcie kthread 触发 RCU stall,在此状态下,内核其实并未直接Panic卡死,每几十秒就会大段的打印cpu的信息, 这着实吓到我了,心想怎么样也不应该连bash都进不去吧。
rcu: INFO: rcu_preempt detected stalls on CPUs/tasks:
        7-....: (1 GPs behind) idle: 1c0
rcu: blocking rk-pcie thread on readl(dbi_base + 0x8bc)

[   63.970433] CPU7 online:1
[   63.970443]  EL2(NS) PC: <0xffffffc00874c2c4> dw_pcie_read+0x44/0xc0
起初看到这样的东西,一头雾水,但求助AI,很快就直到核心的信息是告诉我们cpu7上的任务卡住了:也就是 “ dw_pcie_read+0x44/0xc0”
1. 第一步:找出dw_pcie_read()是被谁调用?
我的第一个任务就是去搞清楚,是谁调用了dw_pcie_read()函数,透过全篇kernel的搜索,写下了它的调用栈:
rk3588-linux_20250321/kernel/drivers/pci/controller/dwc/pcie-designware.c
int dw_pcie_read(void __iomem *addr, int size, u32 *val)
       ↓
rk3588-linux_20250321/kernel/drivers/pci/controller/dwc/pcie-dw-rockchip.c
static u32 rk_pcie_readl_atu(struct dw_pcie *pci, u32 reg)
↓
- enter branch A:
static u32 rk_pcie_readl_ob_unroll(struct dw_pcie *pci, u32 index, u32 reg)
↓
rk_pcie_prog_outbound_atu_unroll()
↓
static void rk_pcie_prog_outbound_atu(struct dw_pcie *pci, int index,int type, u64 cpu_addr, u64 pci_addr, u32 size)
↓
static int rk_pcie_ep_outbound_atu(struct rk_pcie *rk_pcie,phys_addr_t phys_addr, u64 pci_addr,size_t size)
↓
static int rk_pcie_ep_atu_init(struct rk_pcie *rk_pcie)
- enter branch B:
static u32 rk_pcie_readl_ib_unroll(struct dw_pcie *pci, u32 index, u32 reg)
↓
rk_pcie_prog_inbound_atu_unroll()
↓
rk_pcie_prog_inbound_atu()
↓
rk_pcie_ep_inbound_atu()
↓
rk_pcie_ep_atu_init()
- branch A merged with Branch B
↓
(rockchip_dw_pcie_resume) 或
static int rk_pcie_add_ep(struct rk_pcie *rk_pcie)
↓
static int rk_pcie_really_probe(void *p)
↓
static int rk_pcie_probe(struct platform_device *pdev)
↓
static struct platform_driver rk_plat_pcie_driver = {
	.driver = {
		.name = "rk-pcie",
		.of_match_table = rk_pcie_of_match,
		.suppress_bind_attrs = true,
		.pm = &rockchip_dw_pcie_pm_ops,
	},
	.probe = rk_pcie_probe,
};
追到最后的rk_plat_pcie_driver我已经完全清楚了。就是在pcie设备进行probe的阶段,发生的问题。 虽然对内核并不算很熟悉,但是内核里的驱动正是靠这种塞满函数指针的结构体变量来进行注册的。
2. 第二步:找出dw_pcie_read()具体做了什么?
int dw_pcie_read(void __iomem *addr, int size, u32 *val)
{
	// int seq = atomic_inc_return(&dw_pcie_read_seq);

	// /* +++PCIE_HANG_DEBUG+++ before the actual read -- if the readl
	//  * below hangs, the LAST printed "BEFORE" line is the offender. */
	// pr_info("+++PCIE_HANG_DEBUG+++[%05d] dw_pcie_read BEFORE addr=0x%p size=%d\n",
	// 	seq, addr, size);

	if (!IS_ALIGNED((uintptr_t)addr, size)) {
		*val = 0;
		return PCIBIOS_BAD_REGISTER_NUMBER;
	}

	if (size == 4) {
		*val = readl(addr);
	} else if (size == 2) {
		*val = readw(addr);
	} else if (size == 1) {
		*val = readb(addr);
	} else {
		*val = 0;
		return PCIBIOS_BAD_REGISTER_NUMBER;
	}

	// /* +++PCIE_HANG_DEBUG+++ after the read returned -- if you see lots of
	//  * BEFORE lines but no AFTER lines for the same seq number, the read
	//  * that hung is the one whose AFTER never printed. */
	// pr_info("+++PCIE_HANG_DEBUG+++[%05d] dw_pcie_read AFTER  addr=0x%p size=%d val=0x%x\n",
	// 	seq, addr, size, *val);
	return PCIBIOS_SUCCESSFUL;
}
EXPORT_SYMBOL_GPL(dw_pcie_read);

↓

arch/arm64/include/asm/io.h
/*
 * I/O memory access primitives. Reads are ordered relative to any
 * following Normal memory access. Writes are ordered relative to any prior
 * Normal memory access.
 */
#define readb(c)		({ u8  __v = readb_relaxed(c); __iormb(__v); __v; })
#define readw(c)		({ u16 __v = readw_relaxed(c); __iormb(__v); __v; })
#define readl(c)		({ u32 __v = readl_relaxed(c); __iormb(__v); __v; })
#define readq(c)		({ u64 __v = readq_relaxed(c); __iormb(__v); __v; })

#define writeb(v,c)		({ __iowmb(); writeb_relaxed((v),(c)); })
#define writew(v,c)		({ __iowmb(); writew_relaxed((v),(c)); })
#define writel(v,c)		({ __iowmb(); writel_relaxed((v),(c)); })
#define writeq(v,c)		({ __iowmb(); writeq_relaxed((v),(c)); })

↓

/*
 * Relaxed I/O memory access primitives. These follow the Device memory
 * ordering rules but do not guarantee any ordering relative to Normal memory
 * accesses.
 */
#define readb_relaxed(c)	({ u8  __r = __raw_readb(c); __r; })
#define readw_relaxed(c)	({ u16 __r = le16_to_cpu((__force __le16)__raw_readw(c)); __r; })
#define readl_relaxed(c)	({ u32 __r = le32_to_cpu((__force __le32)__raw_readl(c)); __r; })
#define readq_relaxed(c)	({ u64 __r = le64_to_cpu((__force __le64)__raw_readq(c)); __r; })

#define writeb_relaxed(v,c)	((void)__raw_writeb((v),(c)))
#define writew_relaxed(v,c)	((void)__raw_writew((__force u16)cpu_to_le16(v),(c)))
#define writel_relaxed(v,c)	((void)__raw_writel((__force u32)cpu_to_le32(v),(c)))
#define writeq_relaxed(v,c)	((void)__raw_writeq((__force u64)cpu_to_le64(v),(c)))

↓

#define __raw_readl __raw_readl
static __always_inline u32 __raw_readl(const volatile void __iomem *addr)
{
	u32 val;

	log_read_mmio(32, addr);
	asm volatile(ALTERNATIVE("ldr %w0, [%1]",
				 "ldar %w0, [%1]",
				 ARM64_WORKAROUND_DEVICE_LOAD_ACQUIRE)
		     : "=r" (val) : "r" (addr));
	log_post_read_mmio(val, 32, addr);
	return val;
}
一步步追到这里,核心就是这段汇编代码:
	asm volatile(ALTERNATIVE("ldr %w0, [%1]",
				 "ldar %w0, [%1]",
				 ARM64_WORKAROUND_DEVICE_LOAD_ACQUIRE)
		     : "=r" (val) : "r" (addr));
3. 第三步:继续把 readl 追到底,搞清这句汇编为什么会是最后一句代码
我的第一反应是:readl 怎么会挂?要回答,就得把它一路追到最底层。
RCU stall log 里的 dw_pcie_read+0x44/0xc0,那个 +0x44 就是这条 ldr 的指令偏移。
按照现象来反推,应该是CPU 发起的这个ldr 0x44估计是一直没有返回。所以才导致了kthread持续挂起cpu。 我当时在这里兜了非常久,那这个0x44是什么呢?
+0x44 到底是什么?
第一步:+0x44 不是地址,是指令偏移。
dw_pcie_read+0x44/0xc0 的读法是:函数 dw_pcie_read 总长 0xc0 字节,PC 现在停在函数入口往后第 0x44 字节的那条指令上。它回答的是"卡在哪一条指令",不是"读的是哪个地址"。我之前一直把 0x44 当成被读的地址,这是根本的误解。
把这个函数用交叉编译器反汇编出来(aarch64-...-objdump -d pcie-designware.o),偏移 0x44 处清清楚楚:
  ffffffc00874c29c:	7100103f 	cmp	w1, #0x4                                   // size == 4 ?
  ffffffc00874c2a0:	54000120 	b.eq	ffffffc00874c2c4 <dw_pcie_read+0x44>       // 是 → 跳到 0x44 走 readl 分支
  ...
  ffffffc00874c2c4:	b9400001 	ldr	w1, [x0]      // ★ +0x44 就是这一条:从 x0 指向的地址读 32 bit
  ffffffc00874c2c8:	d50331bf 	dmb	oshld
  ffffffc00874c2cc:	2a0103e0 	mov	w0, w1
  ffffffc00874c2d0:	ca000000 	eor	x0, x0, x0
  ffffffc00874c2d4:	b5000000 	cbnz	x0, ffffffc00874c2d4 <dw_pcie_read+0x54>
  ffffffc00874c2d8:	52800000 	mov	w0, #0x0                   	// #0
  ffffffc00874c2dc:	d50323bf 	autiasp
  ffffffc00874c2e0:	b9000041 	str	w1, [x2]
  ffffffc00874c2e4:	d65f03c0 	ret
+0x44 就是 ldr w1, [x0]。被读的地址在寄存器 x0 里,不是 0x44。 x0 是函数第一个参数 addr。
第二步:凭什么说 x0(也就是 addr)指向的是外设,而不是普通内存?
看函数签名:
int dw_pcie_read(void __iomem *addr, int size, u32 *val)
- __iomem
void __iomem *是内核对 MMIO 指针的强制类型标注。整个内核里,带__iomem的指针只指向一种东西:ioremap()出来的外设寄存器映射地址,其页表属性是 Device-nGnRE,不是 Normal memory。普通 RAM 指针是void *,永远不带__iomem。所以从类型系统就能断定:这条ldr打的是一笔 Device memory 事务,走 AXI 总线去够某个 slave 端口,而不是去 DRAM。 其实调试的时候,我当时还没有进行硬件框图的学习(即下面的 “回到 TRM,找 PHY 时钟域的架构依据”)时,其实并不理解AXI master/ AXI slave/ DBI slave/ APB的具体意思是什么。
这解释了那个最要命的而且一直在我心里总感觉哪里不对又问不出来的疑问——“CPU 查自己的内存,为什么会永不返回?” 因为它查的根本不是内存。DRAM 由 memory controller 兜底,永远会回话;而一个 MMIO 地址背后是一颗外设,外设的时钟一旦停摆,它就不回 AXI response。叠上两条协议事实,ldr 就永远等下去:
- AXI 协议层没有 timeout:slave 不返回 Read Response,事务就一直挂着(AMBA AXI Spec, IHI 0022,文档入口
https://developer.arm.com/documentation/ihi0022/latest/) - ARMv8 对 Device-nGnRE 的 load 语义就是死等到完成(Arm ARM, DDI 0487,文档入口
https://developer.arm.com/documentation/ddi0487/latest/)
关于引用的诚实说明。 上面这两条底层原理(AXI 无事务级 timeout、Device-nGnRE load 语义是阻塞到完成)在工程上是常识、也是这次 hang 的机制根据;但我根据AI给出的信息和搜索引擎搜到的说法都还没有办法核准这处的标准内容。
第三步(诚实的边界):光凭这一行 log,能不能断定就是 DBI?—— 不能。
dw_pcie_read 是个通用叶子函数,内核里调用它的不止 DBI 一家。搜一遍就知道,至少还有 ATU:
// pcie-designware.c
dw_pcie_read_dbi():   ret = dw_pcie_read(pci->dbi_base + reg, size, &val);  // DBI
dw_pcie_readl_atu():  ret = dw_pcie_read(pci->atu_base + reg, 4,   &val);  // ATU
而这里也让我疑惑了非常久,到底是谁调用它?太乱了。后来还是读到一句后面的代码才稍微站住脚(详见下面分析)
dw_pcie_read+0x44/0xc0 这行 stall log 里,只有函数符号和指令偏移,没有 x0 的值,所以单看这一行,我只能推到"卡在一次外设 MMIO 读上",推不出具体是 DBI 还是 ATU 的地址。之前直接写"0x44 是 dbi 的地址",是我把结论提前了、证据不足。
要区分 DBI 还是 ATU,得靠别的证据,不是这行 log:
调用栈——但我这次恰恰没有。 理论上,如果 stall 时能拿到完整的函数调用栈(一层层
caller → callee展开),看dw_pcie_read的上一跳是dw_pcie_read_dbi还是dw_pcie_readl_atu,就能直接分开。但我实测拿到的 RCU stall log 根本没有这个。 它是 “detected stalls on CPUs” 模式,给每颗 CPU 只 dump 当前那一条 PC:[ 63.970443] EL2(NS) PC: <0xffffffc00874c2c4> dw_pcie_read+0x44/0xc0就这一行——只有 PC 停在哪条指令,没有上一跳、没有栈帧。所以想靠"看 caller"来分辨 DBI/ATU,这条路在我的 log 上是断的。这也正是我不得不走下面第 2 条的原因。
自己插 printk 既然 log 不给 caller,就可以在
rk_pcie_readl_atu()和 DBI 读路径上各插一对+++PCIE_HANG_DEBUG+++的 ENTER/EXIT,靠"有 ENTER 无 EXIT"精确定位卡在哪条路径上。地址空间关系(这里是我依据的内容):顺带值得一提,RK 驱动里
atu_base = dbi_base + DEFAULT_DBI_ATU_OFFSET(0x3 << 20),ATU 本身就是 DBI 空间里的一段偏移——两者物理上是同一块控制器寄存器区,都在 PHY 的core_clk域后面。所以就算一时分不清是 DBI 还是 ATU,“根因指向 PHY 时钟域"这个方向依然成立;要精确到寄存器,才需要上面 1、2 两条证据。
小结这一段的逻辑链:+0x44(指令偏移)→ ldr w1,[x0](反汇编铁证)→ x0=addr 且类型是 void __iomem *(外设 MMIO,非内存)→ Device-nGnRE + AXI 无 timeout(永不返回的机制)→ ATU是DBI空间里的一段偏移,即可以当成就是DBI没有回应。因此,逻辑链条算是闭环了。
4. 第四步:锁定 DBI 之后,先搞清 DBI 到底是什么——拆 TRM 11.3.1 的四句话
这一段是我真实的思考路径。上一节把现象推到了"卡在一次 DBI 的 MMIO 读上”,但说老实话,那时候我对 DBI 只有个模糊印象。所以我没急着往下猜,而是回头翻 TRM,想先把"DBI 在这颗 controller 里到底是个什么东西、处在什么位置"搞清楚。真正让我豁然开朗的,是 TRM Part 2 Ch.11.3.1 的四句话。
controller 对外一共就 4 个端口。TRM 11.3.1一句话给了清单:
“Application Interface comprises with four standard interfaces: one AXI master interface, two AXI slave interface and one APB interface.”
紧接着 line 20107 用四句话,一句定义一个端口。我把这四句逐句抄下来,每句配一张图——把抽象的英文,变成"数据从哪进、到哪去、过不过 PHY"的物理路径。
句 1 · AXI master —— EP 把数据写进 host 内存
“The AXI master interfaces enable a remote PCIe device to read and write to an AXI slave (in System Interface) connected to the AXI bridge.”
从 EP 到 host DRAM,我把它拆成 7 段线性旅程,每段标注"协议 + 实体":
         ① TLP 协议               ② PCIe 电气               ③ PIPE 接口                ④ Controller 内部 4 步
  ┌──────────────────┐      ┌────────────────┐       ┌───────────────────┐       ┌────────────────────────────────────┐
  │   EP / FPGA      │      │  PCIe wire     │       │  PCIe 3.0 PHY     │       │  PCIe Controller (fe150000)        │
  │   PCIe IP core   │─────►│  (SerDes 差分) │──────► │  (PMA + PCS)      │──────►│                                    │
  │                  │      │                │       │                   │       │  ④a RADM 收 TLP, 解析 header       │
  │   组装 MWr TLP   │ PCIe │  PCIe NRZ /    │  PCIe  │  CDR + 8b/10b 解码│  PIPE  │  ④b iATU 翻译 PCIe→SoC AXI 地址    │
  │   含 header +    │ 物理 │  PAM-4 +        │  数字  │  → PIPE 并行信号   │  协议  │  ④c AXI Bridge 生成 AW/AR/W 事务    │
  │   data payload   │      │  8b/10b /      │       │  (TX/RXData,      │       │  ④d AXI Master port 发出           │
  │                  │      │  128b/130b 编码 │       │  PHYStatus, etc.) │       │                                    │
  └──────────────────┘      └────────────────┘       └───────────────────┘       └────────────────┬───────────────────┘
                                                                                                       │ ⑤ AXI 协议 (PCIe Ctrl → Interconn)
                                                                                                       ▼
                                                                              ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─
                                                                              │ Interconnect 内  │ ← 独立 IP (TRM Ch.1)
                                                                              │ 部: PCIe Master  │
                                                                              │ BIU + crossbar + │
                                                                              │ 4× DDR Scheduler │
                                                                              │ (IP 内部组件)    │
                                                                              ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─
                                                                                                       │ ⑥ AXI 协议 (Interconn BIU → AXI slave)
                                                                                                       ▼
                                                                              ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─
                                                                              │ AXI slave        │ ← 独立 IP, 不是 Interconnect 一部分
                                                                              │ (in System I/F)  │   TRM 句 1 里 "AXI slave (in
                                                                              │ = DDR Ctrl in    │   System Interface)" 指的就是它
                                                                              │ 99% PCIe case)   │
                                                                              │ ⑦ 内部: DDRC +   │
                                                                              │ DDR PHY → DRAM   │
                                                                              │ chips            │
                                                                              ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─ ─
重点:这是一条直链、零分叉,每个方框都是一个独立 IP 块(独立寄存器空间 / 时钟 / 复位)。数据方向 EP → host DDR,全程过 PHY、过 wire,Controller 对外这一段走 mstr_aclk(来自 SoC CRU)。
图里的编号,就是数据流过的先后段落:
- ① TLP 协议:EP / FPGA 的 PCIe IP core 把数据组装成 MWr TLP(含 header + data payload)
- ② PCIe 电气:TLP 上 PCIe wire,SerDes 差分信号(NRZ / PAM-4 + 8b/10b / 128b/130b 编码)
- ③ PIPE 接口:PCIe 3.0 PHY(PMA+PCS)做 CDR + 解码,把模拟差分还原成 PIPE 并行数字信号
- ④ Controller 内部 4 步:进 controller 后的翻译流水线——
- ④a RADM 收 TLP、解析 header
- ④b iATU 把 PCIe 地址翻译成 SoC AXI 地址
- ④c AXI Bridge 生成 AW/AR/W 事务
- ④d AXI Master port 把事务发出去
- ⑤ / ⑥ AXI 协议:两个不同的 AXI 实例——⑤ 是 PCIe Ctrl → Interconnect 入口,⑥ 是 Interconnect BIU → AXI slave
- ⑦ DDRC → DRAM:AXI slave(99% 是 DDR Controller)内部 DDRC + DDR PHY 最终写进 DRAM chips
句 2 · AXI slave “outbound” —— CPU 把数据写给 EP
“The AXI link slave interface enables an AXI master (in System Interface) to read and write through the AXI bridge to a remote PCIe device.”
方向跟句 1 相反(CPU → EP),走的物理连接大部分是同一条 PCIe wire,只是软件视角反过来:
    (1) AXI master      (2) AXI 协议        (3) Controller 内部 4 步             (4) PIPE 协议
       (SoC 端)         (CPU→Pcie 端口)     (AXI→TLP 翻译, 跟句1反向)            (Ctlr→PHY)

   ┌────────────┐    ┌────────────┐    ┌──────────────────────┐    ┌────────────┐    ┌────────────┐    ┌────────────┐
   │ SoC CPU    │    │ SoC Fabric │    │ PCIe Controller      │    │ PCIe 3.0   │    │ PCIe wire  │    │ EP PCIe IP │
   │ (AXI       │═══►│ (AXI 协议)  │═══►│ (fe150000)            │═══►│ PHY        │═══►│ (SerDes    │═══►│ core        │
   │  master)   │    │            │    │                       │    │ (PMA+PCS)  │    │  差分对)    │    │ (FPGA 内部) │
   │            │    │ 路由到 PCIe │    │ 3a AXI slave outbound │    │            │    │            │    │             │
   │ 写         │    │ AXI slave   │    │ 端口接收              │    │            │    │            │    │             │
   │ 0xF0000000 │    │ outbound    │    │ 3b iATU outbound      │    │            │    │            │    │             │
   │ + 偏移      │    │ 端口        │    │ AXI addr → PCIe addr  │    │            │    │            │    │             │
   │ (outbound  │    │             │    │ 3c AXI Bridge 拆      │    │            │    │            │    │             │
   │  window)   │    │             │    │ AXI 字段              │    │            │    │            │    │             │
   │            │    │             │    │ 3d XADM 组 TLP        │    │            │    │            │    │             │
   │            │    │             │    │ (MWr header + data)   │    │            │    │            │    │             │
   └────────────┘    └────────────┘    └──────────────────────┘    └────────────┘    └────────────┘    └────────────┘
跟句 1 结构对称、方向相反:句 1 收包用 RADM,句 2 发包用 XADM。数据方向 CPU → EP,同样过 PHY、过 wire,端口走 slv_aclk(来自 SoC CRU)。
图里的编号(顶部 (1)(4) 是大段,Controller 内部再拆 3a3d):
- (1) AXI master(SoC 端):CPU 执行
str指令,目标地址落在 outbound window,SoC AXI master 把它发出去 - (2) AXI 协议:SoC fabric 把事务路由到 PCIe 的 AXI slave outbound 端口
- (3) Controller 内部 4 步(AXI→TLP 翻译,跟句 1 反向)——
- 3a AXI slave outbound 端口接收 5 通道 AXI 信号
- 3b iATU outbound:AXI 地址 → PCIe 地址(跟句 1 的 inbound 方向相反)
- 3c AXI Bridge 拆出 AXI 字段
- 3d XADM 把字段组装成 MWr TLP(header + data)
- (4) PIPE 协议:Controller 把 TLP 切成 PIPE 并行信号交给 PHY,再经 PHY → PCIe wire → EP
句 3 · DBI slave —— CPU 戳 controller 自己的寄存器 ★ 我就卡在这
“The DBI slave enables an AXI master (in System Interface) to access the controller’s registers.”
这条路径的最大特点:数据完全不经过 PCIe wire,留在 SoC 内部——
   (1) SoC CPU           (2) SoC fabric         (3) PCIe Controller                  (4) 跨时钟域边界
      (AXI master)          (AXI 协议)             DBI slave port                       (条件性, 详见下图)

   ┌─────────────┐    ┌──────────────┐    ┌───────────────────────┐    ┌──────────────────────┐
   │ SoC CPU     │    │ SoC Fabric   │    │ PCIe Controller        │    │ 内部访问 core 寄存器时 │
   │ (AXI master)│═══►│ (AXI 协议)    │═══►│ (fe150000)              │═══►│ 需要穿过 core_clk 边界  │
   │             │    │               │    │                         │    │ (core_clk 来自 PHY)     │
   │ 写          │    │ 路由到 PCIe    │    │ 3a AXI slave DBI port   │    │                         │
   │ 0xF5000000  │    │ DBI slave 端口 │    │ (dbi_aclk 域) 接收      │    │  如果 phy_ready=0:       │
   │ + 偏移      │    │               │    │ 3b CDM 寄存器堆查找     │    │  AXI 请求 HOLD 等 PHY    │
   │ (DBI window │    │               │    │ (Standard PCIe config + │    │                         │
   │  4MB)       │    │               │    │  Port Logic registers)  │    │  [这就是 hang            │
   │             │    │               │    │ 3c 寄存器读/写          │    │   的架构根因]            │
   │             │    │               │    │ 3d 把数据返回 CPU       │    │                         │
   └─────────────┘    └──────────────┘    └───────────────────────┘    └──────────────────────┘
跟句 1 / 句 2 的最大区别:没有 PHY、没有 PCIe wire、没有 EP——数据不经过 PCIe 线,终点是 Controller 内部的 CDM 寄存器。
图里的编号:
- (1) SoC CPU(AXI master):CPU 执行
ldr,目标地址落在 DBI window - (2) SoC fabric:跟句 2 同一条 fabric,但路由目标是 DBI slave(不是 outbound slave)
- (3) DBI slave port(
dbi_aclk域)——- 3a AXI slave DBI 端口接收
- 3b CDM 寄存器堆查找(Standard PCIe config + Port Logic 寄存器)
- 3c 寄存器读/写
- 3d 把数据返回 CPU
- (4) 跨时钟域边界:条件性的一步——只有当 3c 访问的寄存器落在 core 域时才发生,见下图放大
但要命的是:如果读的是 core 域寄存器(比如 0x8bc),第 (4) 步这条路会跨进 PHY 的 core_clk 域。把那一步单独放大来看——
   ┌─────────────── dbi_aclk 域 (SoC CRU, 不依赖 PHY) ──────────────┐
   │                                                                 │
   │  CPU AXI master → AXI slave DBI port (3a)                      │
   │       │                                                         │
   │       ▼                                                         │
   │  CDM 寄存器查找 (3b)                                            │
   │       │                                                         │
   │       ▼                                                         │
   │  寄存器读/写 (3c) — 如果访问的寄存器**完全在 dbi_aclk 域内**     │
   │       │           → 立即返回, 不需要等 PHY                       │
   │       │                                                         │
   │       ▼                                                         │
   │  寄存器读/写 (3c) — 如果访问的寄存器**跨进 core_clk 域**          │
   │       │           (比如 0x8bc MISC_CONTROL_1_OFF 等 core 寄存器) │
   │       ▼                                                         │
   │  ════════════════ 跨时钟域边界 (CDC) ═══════════════════         │
   │       │                                                         │
   └───────┼─────────────────────────────────────────────────────────┘
           │
           ▼
   ┌─────────────── core_clk 域 (来自 PHY pipe_clk) ─────────────────┐
   │                                                                 │
   │  core 域寄存器访问                                               │
   │       │                                                         │
   │       ▼                                                         │
   │  PHY ready? ─── 否 ──► HOLD, 永远等                            │
   │       │                                                         │
   │      是                                                         │
   │       ▼                                                         │
   │  寄存器访问完成, 返回 dbi_aclk 域                               │
   │                                                                 │
   └─────────────────────────────────────────────────────────────────┘
这张图正是我 hang 的架构根因:DBI 端口本身在 dbi_aclk(SoC CRU)域,但一旦访问的寄存器落在 core_clk(PHY pipe_clk)域,PHY 没 ready 就会被 HOLD、永远等。
句 4 · APB slave “Client” —— CPU 戳 RK 自家胶水寄存器
“The APB enables Application to access the Client registers.”
这是四条路里最简单的一条,也是我后来的对照组——4 段就到终点,完全不依赖 PHY:
   (1) SoC CPU          (2) SoC APB fabric       (3) PCIe Controller            (4) Client registers
      (APB master)          (APB 协议)              APB slave port                  (Client Logic)

   ┌─────────────┐    ┌──────────────┐    ┌─────────────────────┐    ┌──────────────────────┐
   │ SoC CPU     │    │ SoC Fabric   │    │ PCIe Controller      │    │ Client Logic          │
   │ (APB master)│═══►│ (APB 协议)    │═══►│ (fe150000)            │═══►│ (RK 自家胶水)          │
   │             │    │               │    │                       │    │                       │
   │ 写           │    │ 路由到 PCIe  │    │ 3a APB slave port     │    │ 0x000 GENERAL_CON     │
   │ 0xFE150000  │    │ APB slave    │    │ (apb_clk 域)         │    │ 0x300 LTSSM_STATUS    │
   │ + 偏移      │    │ 端口         │    │ 3b APB 译码           │    │ 0x800 CLIENT_VER      │
   │ (APB window │    │              │    │ (找对应寄存器)        │    │ 中断 mask / PHY reset │
   │  64KB)      │    │              │    │ 3c 寄存器读/写        │    │                       │
   │             │    │              │    │ 3d 数据返回           │    │                       │
   └─────────────┘    └──────────────┘    └─────────────────────┘    └──────────────────────┘
跟句 3(DBI)的本质区别只有一处:APB 完全待在 SoC 的 apb_clk(= PCLK_PCIE_4L)域里,从头到尾不跨进 core_clk,PHY ready 不 ready 跟它无关。这就是为什么后面那个实验里,4 条 APB 读能在 37 微秒内全部返回,而紧接着的 DBI 读一片沉默。
图里的编号:
- (1) SoC CPU(APB master):CPU 通过 APB 总线读
0xFE150000 + offset;APB 比 AXI 简单得多——单拍、无 burst、无 outstanding - (2) SoC APB fabric:APB 总线路由到 PCIe 的 APB slave 端口
- (3) APB slave port(
apb_clk域)- 3a APB slave 端口接收
- 3b APB 译码(找对应寄存器)
- 3c 寄存器读/写
- 3d 数据返回
- (4) Client registers:终点是 RK 自家胶水寄存器(GENERAL_CON / LTSSM_STATUS / CLIENT_VER / 中断 mask / PHY reset 等)
四张图拼到一起
到这里,我才有了拍大腿的酣畅感:
- 所以DBI就是AXI slave,走的就是AXI总线。
- 应该把他们当成四个门,每个门都是独立的,要做任何一件事情都只能走那个IP固化的时候就定好的“门”,决不能混用。
- DBI就主管CPU(走AXI master端口)访问控制器内部的寄存器。
可是现在,我又陷入了迷惑,因为AI建议我做一次APB的寄存器的读取,因为它怀疑APB没有问题,而DBI读取有问题,至于原因就先不说,先做实验。
5. 第五步:一个起初认为没有必要做的实验——APB 通,DBI 挂
于是我让AI加了个探测函数,在 DBI 访问之前先读 4 个 APB 寄存器,每个读的前后各打一条 BEFORE/AFTER printk——一旦哪个卡住,靠"有 BEFORE 无 AFTER"就能精确定位。实测 log:
[3.981072] probe_apb_snapshot() ENTER
[3.981082] apb_snapshot LTSSM_STATUS   val=0x00000000 ltssm_state=0x0
[3.981089] apb_snapshot CLIENT_VER     val=0x00050610
[3.981098] apb_snapshot GENERAL_CON    val=0x00000000 app_ltssm_enable=0
[3.981105] apb_snapshot LOCAL_CRU_CTRL val=0x00000000
[3.981109] probe_apb_snapshot() EXIT (all 4 APB reads returned)
[3.981114] dw_pcie_dbi_ro_wr_en() BEFORE_READL reg=0x8bc
[之后无任何后续 log —— 挂死]
这是整个调试里最关键的一步。 4 条 APB 读全部返回,耗时 37 μs;紧接着 DBI 的 readl(0x8bc) 之后一片沉默。两个数字尤其有说服力:
CLIENT_VER = 0x00050610—— 跟 TRM 文档完全一致,说明控制器 IP 版本对、APB slave 硬件完全正常- APB 全通、DBI 独挂 —— 假设 A 被彻底排除
排除掉的东西列一列,才看得出这一步的价值:不是 PD_PCIE、不是 apb_clk、不是 wrapper AXI 层、不是 SCMI/M0 firmware、不是 DWC IP 版本。打击面从"整个 PCIe 子系统"收窄到了"PHY 时钟域"这一小块。
一个 30 分钟写完、烧录一次的实验(4 条 printk),就把"PHY 层可能有问题"的猜测,变成了"PHY 层必然有问题"的证据。
但是我还是不认为完整了,因为还没解释为什么DBI有问题,APB就没问题呢?这就是牵扯到很麻烦的时钟域(Clock Domain)。
6. 第六步:回到 TRM,找 PHY 时钟域的架构依据
有了实验证据,我才回头认真读 TRM——这时候读,是带着明确问题去读,不是漫无目的地啃。
我要回答的问题很具体:为什么"CPU 通过 DBI 读一个控制器寄存器"这件事,会失败,而且AI认为这原因是跟 PHY 的时钟有关系? 直觉上 DBI 就是一条本地总线,CPU 戳寄存器而已,凭什么要等 PHY?下面这条链,我一环一环用我找到的 TRM 原文接起来——每一句都是直接截取。
环 1 —— 控制器分成 “RAW core” 和 “glue logic” 两块,“core” 是 TRM 自己的词。
TRM 11.3:“Each Controller consists of RAW core and some application glue logic, like Client and CLK/RST block. The RAW core implements of the PCIe protocol and mode-specific features, including several AXI bus interface, RADM/XADM/CDM/eDMA/PMC/CXPL.”
所以TRM 把一个控制器实例拆成 RAW core(跑 PCIe 协议的那堆模块,含 CDM)和 Client 等 glue logic 两部分。记住这个二分,后面全靠它。
环 2 —— DBI 访问的目标区,TRM 命名为 CoreRegister;APB 访问的是 ClientRegister。
这是最关键、也最容易被一句"DBI 就是访问控制器寄存器"糊弄过去的一环。
TRM 的内部地址映射表里,每个控制器实例列了三段空间,Device 那一列写死了它们各自的类型:
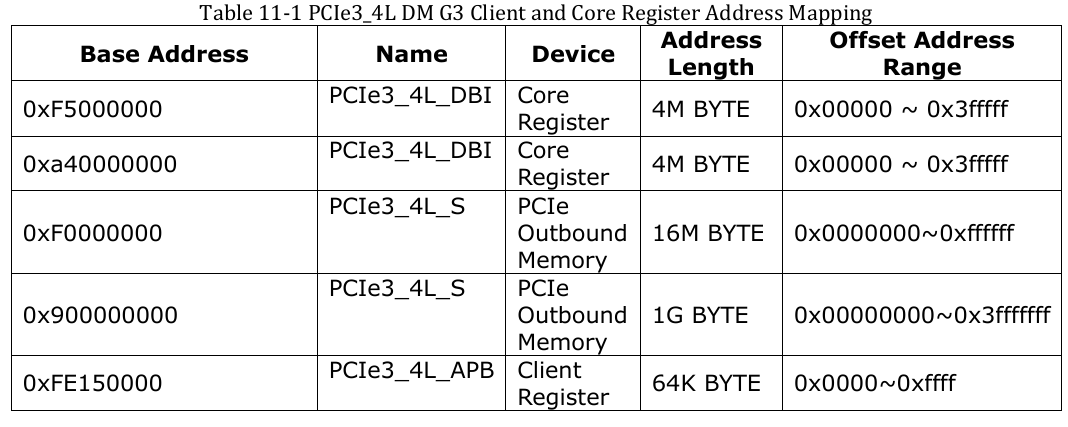
TRM 11.4.1 Table 11-1 逐字摘录关键三行:
Base Address Name Device 0xF5000000PCIe3_4L_DBI CoreRegister 0xF0000000PCIe3_4L_S PCIeOutboundMemory 0xFE150000PCIe3_4L_APB ClientRegister
看清楚:DBI 那段空间的设备类型,TRM 直接标成 CoreRegister;APB 那段标成 ClientRegister。 对上环 1 的二分——DBI 打到的正是 RAW core,APB 打到的是 Client glue logic。所以"DBI → core"不是等价代换,是 TRM 地址表的原话。(另外几个实例 Table 11-2~11-5 完全同构,不再列。)
再补一句 DBI 的定义,这里变着法儿的告诉读者,DBI就是用来做"本地 CPU 访问寄存器",如果远程RC访问就不叫DBI了:
TRM 11.4:“PCIe Registers can be accessed by either local CPU through AXI DBI bus or remote RC device through PCIe link… The way through local CPU will be mentioned as ‘DBI’.”
所以,当AI扒出这处的原话时,我都震惊了,虽然难以置信,但是似乎应该不会牵强附会的,寄存器这里的Core和后来时钟域里的Core以及DBI所访问的CPU寄存器应该都是指着同一个对象来说的。这里是逻辑重要的衔接点。
环 3 —— core_clk 就是"the controller clock",而它由 PHY 生成。
RAW core 跑在什么时钟上?TRM 把 core_clk 直接定义成"控制器时钟",并说它来自 PHY:
TRM 11.6.1.1:"Core function clock is derived from the PIPE interface clock output from the PCIe PHY." TRM(RADM 一节):“The RADM clock is a gated version of the controller clock, core_clk.”
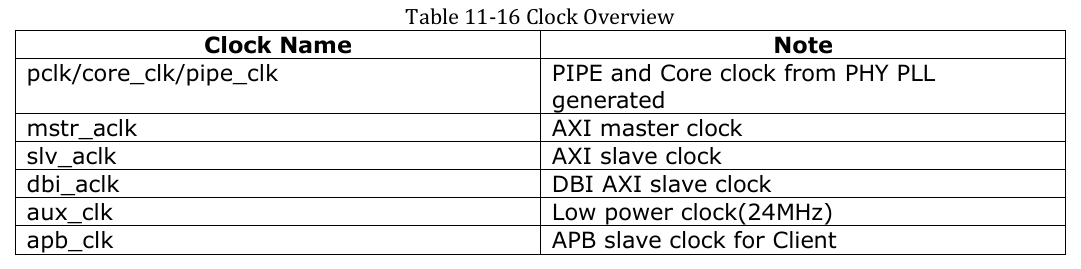
TRM 11.6.1.1 Table 11-16 逐字摘录关键三行:
Clock Name Note pclk/core_clk/pipe_clkPIPE and Core clock from PHY PLL generated dbi aclkDBI AXI slave clock apb_clkAPB slave clock for Client
环 4 —— 端口自己的时钟(dbi_aclk/apb_clk)来自 SoC,不是 PHY。
这一环用来堵死一个常见误解——“DBI 挂是因为 DBI 的时钟没了”。不是。DBI 端口时钟好好的:
TRM 11.6.1.1:“The system bus clock is generated from SOC main PLL internally…”
配合环 3 的 Table 11-16:dbi_aclk/apb_clk 是 system bus clock(SoC CRU 出的),跟 PHY 没关系。所以 DBI 依赖 PHY 的地方,不在端口时钟,而在它要访问的目标——core 寄存器所在的 core_clk 域。 一句话概括:不是"DBI 的时钟依赖 PHY",而是"DBI 访问的目标(core 域寄存器)依赖 PHY"。
环 5 —— PHY 没 ready 时,经 AXI slave 访问 core 会被 hold。
TRM 11.6.1.1:“After power up, if the PHY is not ready(phystatus is not de-assert), accessing the core through AXI slave will be held until it is ready.” TRM 11.6.1.1:“The PCIe link Training and transaction is completely dependent upon availability of this clock. Application should not initiate transactions before ensuring that the PHY PLL is locked.”
环 6(唯一的推断,不是逐字原文)—— 被 hold 的"AXI slave"涵盖 DBI 这条路。
必须诚实:line 23853 字面写的是"the core through AXI slave",它没有逐字写 “DBI”。而控制器有两个 AXI slave:
TRM 11.3.1:"…four standard interfaces: one AXI master interface, two AXI slave interface and one APB interface." TRM 11.3.1:“The AXI link slave interface enables an AXI master… to read and write through the AXI bridge to a remote PCIe device. The DBI slave enables an AXI master… to access the controller’s registers.”
两个 AXI slave 里,一个是 link slave(出站到远端 PCIe 设备,过 wire,依赖 PHY 是显然的),另一个是 DBI(目标就是环 2 里 TRM 命名的 CoreRegister)。23853 说被 hold 的是"the core",而目标叫 “Core” 的 AXI slave 只有 DBI。所以"经 DBI 访问 core 寄存器会被 hold",是把环 2 + 环 5 接起来的推断——强,但 TRM 没有单独写一句 “DBI will be held”。这是全链条唯一需要我自己接一下逻辑的地方。
六环接完,结论就站得住了:CPU 通过 DBI 读 0x8bc 这类寄存器(环 2/3:它落在 CoreRegister / core_clk 域)→ core_clk 由 PHY 的 PIPE clock 派生(环 3)→ 端口时钟 dbi_aclk 虽在(环 4),但访问要跨进 core_clk 域 → PHY 没 ready,这笔访问被 held、永不返回(环 5/6)。对应到最底层,就是那条 ldr 因为 AXI slave 不回 response 而永远停在那里。
以下是ai的搜索和分析,我无法立刻验证,但选择记录下来:
再看 SDK 的 PHY 驱动,问题就很显眼了:rockchip_p3phy_rk3588_init() 只 poll 了 SRAM_INIT_DONE(bit 0),函数体里没有任何 PLL-lock 相关的等待。而 TRM Ch.11.6.2.1 Step 8 明确要求:“Delay some time or wait PLL lock if the PLL lock flag is accessible”。SDK 代码违反了这一步。
诚实的边界 TRM 说访问会被 “held”,但没有描述内部实现机制(异步 FIFO / 握手门控 / clock gating 都可能)。Synopsys 的 DWC Databook 是 NDA,我没有渠道。所以我的证据链只推到"held until PHY ready"这一层为止——这已经足够指导下一步(补 PLL lock 等待),我没有必要往更深的内部机制去猜。知道自己的证据到哪为止,和知道结论本身一样重要。
总结:四个端口的时钟域对照
各有各的时钟域、各有各的数据终点、过不过 PHY 也各不相同。端口时钟出处见 TRM 11.6.1.1 Table 11-16,数据终点的寄存器归属见 TRM 11.4.1 Table 11-1(DBI 段 Device=CoreRegister、APB 段 Device=ClientRegister)——这两张表上面环 2、环 3 已逐字引:
| 端口 | 句 | 数据终点 | 过 PCIe wire? | 端口时钟域 | 依赖 PHY? | PHY 没 ready 时 |
|---|---|---|---|---|---|---|
| ① AXI master | 句1 | SoC DDR | 是 | mstr_aclk(CRU) | 是 | 数据进不来 |
| ② AXI slave outbound | 句2 | 远端 EP | 是 | slv_aclk(CRU) | 是 | TLP 发不出 |
| ③ AXI slave DBI | 句3 | controller 的 CoreRegister 区(RAW core,含 CDM) | 否 | 端口 dbi_aclk(CRU);但目标寄存器在 core_clk(PHY)域 | 是(藏在目标侧) | 访问 core 寄存器 HOLD,永不返回 |
| ④ APB slave Client | 句4 | controller 的 ClientRegister 区(Client glue) | 否 | apb_clk = PCLK_PCIE_4L(CRU) | 否 | 完全正常 |
③ 那一行要特别说清楚,免得被误读成"DBI 的时钟依赖 PHY":DBI 端口自己的时钟 dbi_aclk 来自 SoC CRU,好好的;依赖 PHY 的是它要访问的目标——CoreRegister 落在 core_clk 域,而 core_clk 由 PHY 的 PIPE clock 派生。 依赖藏在目标侧,不在端口侧。
这张表里,③ 和 ④ 是我最在意的一对:它俩结构几乎一样——都是"CPU 戳 controller 自己"、数据都不出 SoC、都不过 wire。唯一的区别是 ③ DBI 访问 core 寄存器时,寄存器所在的时钟域乃是受到 PHY 时钟影响 的 core_clk 域,而 ④ APB 完全待在 SoC 的 apb_clk 域里,从头到尾不碰 PHY。
到这里,我手里就有了一个天然的对照组:DBI 和 APB 只差一个"跨不跨 PHY 时钟域"。要是 DBI 挂、APB 通,就能把故障死死钉在 PHY 时钟域上——不是电源、不是 wrapper、不是 APB 域本身。这个"四句话 → 四端口独立"的架构认识是认知的框架,让我反复思考了很久,反复查找,反复验证。
7. 第七步:先查最靠前的一层——电源域
其实做到这里的时候,还是有些凌乱的,虽然踉踉跄跄找到了整条出错的脉络。但在发现自己自始至终没有检查过电源的时候,还是非常吃惊的,自己在调试这种高速的总线信号的时候,竟然完全不知道如何去查电源,好像所有注意力都集中在18根差分的数据Rx Tx线和4根差分参考时钟线上。
因此,便试着去确认到底,电源开了没有。 于是我查了一下:
$ cat /sys/kernel/debug/pm_genpd/pm_genpd_summary
pcie                            off-0
off-0 = 电源域关着,refcount 0。一查代码,SDK 的 pcie-dw-rockchip.c 完全没有任何 pm_runtime_* 调用,而设备树声明了 power-domains。Linux GenPD 是显式引用计数模型:没人 pm_runtime_get,它就一直 off。
我请AI帮忙补上了 pm_runtime_enable + pm_runtime_get_sync。结果:电源域上电了,但 readl(0x8bc) 依然 hang。
虽然我这里这么做了,但是内心里总是认为,或许RK原版的驱动人家这么写,不一定是电源没上的原因。不过,还是抱着试一试的心态,让AI做了一些修补。 开了之后依然还是RCU Stall,于是这一块我就放下了,继续去查其他原因。 不过也让我稍微的有了那么一些想法。要去动一动内核,按照TRM和Datasheet,既然人家内核和驱动都开源了,那我们也可以来改一改。
走过的弯路,但不算白走。 后来发现真正的病根在时钟不在电源,但"电源必须先开"这一条依然是对的——只是不够。
8. 第八步:一条看似可行的路,怎么被我"不烧板"就否决了
顺着"PHY 缺时钟"往下,尝试向RK原厂求证,Port0/1的时钟和电源部分的要求,而对方给的回答很坚决,必须要同时启用Port0/1的100M时钟和电源。
可是我从硬件同事处得到的结果是:Port1不需要时钟,共用Port0的。
因此,跟我的检查结果几乎是完全对上的:pcie3x4 的 PHY 缺 refclk。
但我同时在思考一件事:能不能用 SoC 内部 100MHz(走 ref_alt_clk)替代外部时钟?
我没有急着照着烧板,而是先纯读源码 + 一份已有的 clk_summary 做了三路交叉验证:
证据①(源码):那 4 个 REF_ALT 时钟的宏是 GATE(...) 不是 COMPOSITE(...)——只有开关,没有分频器,parent 写死 "ppll"。所以它们的频率恒等于 PPLL,你无法把它单独设成 100M。
证据②(对照):作为对比,combo PHY 用的是 COMPOSITE_NOMUX(... 0, 6, ...),自带 6-bit 分频器(1100M ÷ 11 = 100M)。这才是 Rockchip 官方的正规设计:高频 PLL + 独立分频。pcie3x4 的 REF_ALT 偏偏缺这一层。
证据③(PLL rate 表):rk3588_pll_rates[] 全表最低只到 96M,根本没有 100M 这一档。就算硬拉 PPLL,也退到 96M——超出 PCIe ±300ppm 容差,PHY 照样锁不住。
证据④(板端 clk_summary):PPLL 下游同时挂着 aclk_sata2=396M、aclk_usb3otg=300M 且都在用。拉低 PPLL 会连锁把 SATA/USB3 总线一起搞崩。
pll_ppll                       1  1  0  1100000000
   ppll                        2  2  0  1100000000
      clk_ref_pipe_phy0_pll_src 1 1 0   100000000   ← combo PHY 靠分频拿到 100M
            aclk_sata2          1  1  0   396000000  ← ★ 同在 ppll 树下,正在用
            aclk_usb3otg0       1  2  0   300000000  ← ★
证据⑤(决定性铁证):直接看那 4 个 pcie3x4 的 ref_alt gate 实测频率:
clk_phy0_ref_alt_p     0   0   0   1100000000   ← rate=1100M 不是 100M;enable=0 没人用
clk_phy0_ref_alt_m     0   0   0   1100000000
clk_phy1_ref_alt_p     0   0   0   1100000000
clk_phy1_ref_alt_m     0   0   0   1100000000
rate=1100M 就地验证了证据①(无分频器,输出等于 PPLL);enable=0 说明官方 DT 根本没把 pcie3x4 接到这条内部 refclk 上——Rockchip 对 pcie3x4 的设计就是走外部 pad 时钟(ref_use_pad=1 是复位默认)。这条内部路径是 silicon 留了 mux、但 CRU 侧没配好 100M 源的半成品。
三段论钉死:内部 refclk 要 100M,只能靠拉低整颗 PPLL;但 PLL 表无 100M 档,且 PPLL 还要供 SATA/USB3 的高频总线——两个频率要求互斥,这条路结构性不可行。
靠读三处源码 + 一份已有 log,我把这个看起来完全可行的尝试判了死刑。方向就此中断,内部时钟不行不是SOC不允许,而是RK的驱动自始自终没打算让我们这么做,所以即便要完全配置起来,要涉及的模块将会是USB/SATA/GMAC(combophy)等多处。因此,只能相信原厂的信息,只能外界100M时钟,而且两个Port都需要。
9. 反思:这次调试到底教会了我什么
链路最终没在我手里调通,卡在"外部时钟芯片"这一步交接了出去。但回头看,这次的过程已经是大大成功了,因为我有机会遍历整个pcie的驱动调用栈和硬件架构图并将所有设想逐一的上板验证,这种经历,比单纯只是"调通一个 PCIe"更值钱。
依然有很大的“未探测区域”
例如对每一个时钟的信息和作用(在drivers/clk/rockchip/clk-rk3588.c),我几乎都不熟悉,可以猜到,但是仅限于猜。
pcie的原理,ATU/MSIx/outbound/inbound只是浮于表面的理解,完全谈不上掌握,更别说我要故意抠一些细节,例如outbound/inbound的位数在何时有影响,dts里常见16/8位,何时会不够用? 这是一件遗憾的事情,但也是嵌入式的魅力,嵌入式不是一种技术,不是一套技术栈,甚至都不仅是一个行业,它是一种产品形态,一种非标设备定制化的产品形态,任何符合这个形态的,都有嵌入式开发的身影。
这也让我思考:尽自己的努力没有错,但方式一定要对,随时保持宏观全局的视角看问题,看手中的调试工作,尤其是AI来了之后,信息密度远胜于从前,比我刚参加工作时信息量大得多的多,开发效率也提升得多得多,但是那种本质仍然没有改变,随时保持冷静和宏观把握,是秘诀。
精华不是"调通",是找到整条事情的脉络
如果我只是碰运气试出某个 magic 的初始化顺序让它通了,却说不清为什么——那没有意义。反过来,我虽然没调通,但我能拿出一条完整的证据链:hang 在 DBI 的 core 寄存器访问 → 因为 core_clk 依赖 PHY PLL → PHY 驱动没等 PLL lock → 内部时钟路线结构性不可行 → 只能走外部时钟。这条脉络本身,就是交付物。 接手的人不用从头再猜一遍。
尤其是失败的时候最考验这个。成功了大家都默认自己做得对;失败了,多数人是找到一个显眼的报错就一拥而上,指认它是根因。但内核层层封装、控制器又套了厂商 wrapper,一层层调用——单拿一个显眼的错误就说找到了根源,是不牢靠的。这次我逼自己每一步都做到"可证伪":APB 对照实验、clk_summary 铁证,都是为了不靠"我觉得"。
bring-up 的根本矛盾:有限的时间 vs 无限的打击面
bring-up 永远很赶。不是没有时间预算,而是你面对的可能是 3500 万行内核里的任何一个问题,而你不可能现场把内核学精通了再回来调。所以最重要的能力不是"懂得多",是缩小打击面:
- 缺席即证据——“有 BEFORE 无 AFTER"锁定了 hang 的位置;“ref_alt gate 的 enable=0"证明了官方从不走内部时钟。我学会了不只盯"log 显示了什么”,也盯"该显示却没显示什么”。
- 两个相邻端口互为对照——DBI 和 APB 结构几乎一样、只差一个时钟域,这个"几乎一样"正是它们能互为判别器的前提。找对照物,是收窄打击面最快的手段。
- 有寄存器 ≠ 能用——
ref_use_pad这个 mux 确实存在,容易让人以为"切一下就行";但 CRU 侧没配好可用的源。分清"芯片能力"和"BSP 完成度",省掉了一整条白烧板的路。
这三条判据,已经脱离了 PCIe 本身。它们连同我"先扫盲协议 → 从 dts 入手 → 对照原理图 → 抓 log → 读 TRM 架构 → 抠 IP 子通路"的整条主线,一起沉淀成了我自己的一套方法:
这次 PCIe 调试,就是那套方法在"第 7 步·专项定位 IP 子通路"这一层的完整实战。
参考资料
- RK3588 TRM Part 2 Ch.11.3.1 / Ch.11.6.1.1 / Ch.11.6.2.1
- PCI-SIG:Vendor ID
0x1d87= Rockchip(公开) - Linux kernel
drivers/pci/controller/dwc/pcie-dw-rockchip.c(RK glue)、pcie-designware.c - Linux kernel
drivers/phy/rockchip/phy-rockchip-snps-pcie3.c(PHY driver)、drivers/clk/rockchip/clk-rk3588.c - ARM AMBA AXI Protocol Spec IHI 0022 §A3.1.3
- Arm Architecture Reference Manual DDI 0487 §B2.3